NVIDIA
NVIDIA H200 (SXM)- Form factor: SXM (HGX)
- Architecture: NVIDIA Hopper
- Cooling: Passive (server airflow)
Tarif
Sur devis
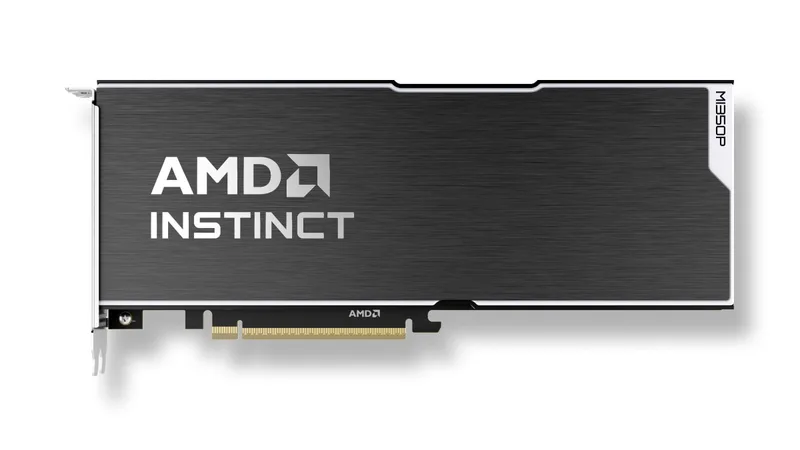
Image du produit à titre d'illustration ; la configuration peut différer.
PCIe card with 144 GB HBM3E for running generative AI inside the servers you already have. Priced on quote.
| Cooling | Passive (server airflow) |
|---|---|
| Peak FP16 / BF16 matrix | 1.15 PFLOPS |
| Software | AMD ROCm (Linux x86-64) |
| Memory bandwidth | Up to 4 TB/s |
| Form factor | PCIe 5.0 x16, full height, double slot, 267 mm |
| Peak FP8 (OCP) | 2.3 PFLOPS (4.6 with sparsity) |
| Architecture | AMD CDNA 4 |
| Board power | 600 W (450 W configurable) |
| Peak FP64 | 36 TFLOPS |
| Power connector | 12V-2x6 |
| Peak MXFP4 / MXFP6 | 4.6 PFLOPS |
| Compute units | 128 (8,192 stream processors) |
| GPU memory | 144 GB HBM3E, 4096-bit |
AMD Instinct MI350P 144 GB PCIe est fabriqué sur commande et chiffré par projet (configuration, livraison, installation et support).
Choisissez le modèle et la quantification que vous comptez utiliser. Nous vous montrons s'il tient en mémoire, la place restante pour le contexte et le débit attendu. Les estimations reposent sur la bande passante mémoire et sont remplacées par nos propres mesures quand nous en avons.
Machine
Quantification
Confortable. 70 GB de marge — de la place pour un contexte de 128k, un deuxième petit modèle ou un index RAG en mémoire. Comptez environ 3.8 tok/s en flux unique.
Machines qui font tourner cette configuration
Poids 42.8 GB à 4.85 bits/paramètre · cache KV 5.0 GB à 16k (fp16, approximatif) · 10 GB réservés à l'OS et au runtime. La vitesse correspond au décodage en flux unique, limité par la mémoire ; le traitement du prompt et le batching se comportent différemment. Ou contactez un ingénieur sur WhatsApp au +44 7515 356 146.
The MI350P puts AMD's 4th-generation CDNA architecture on a standard double-slot PCIe card. With 144 GB of HBM3E on a 4096-bit interface and up to 4 TB/s of bandwidth, a single card holds models that would need two smaller GPUs, and the new MXFP4 and MXFP6 data types speed up inference further. Board power is 600 W, or 450 W where your rack's power or cooling budget is tighter.
It runs on AMD ROCm, the open software stack, with PyTorch, TensorFlow, JAX, Triton, SGLang and ONNX Runtime support and no per-GPU licence fees.
Fitted in a Workstation or Dell server, or supplied standalone where the form factor allows. Before it ships we check it against your chassis (power, airflow, slot layout and platform support), burn-in test it and install the AMD ROCm drivers and software stack. Warranty claims and advance replacements are handled by us, and support comes from our own UK engineers.
Priced on quote: tell us what you need and we will confirm price, availability and lead time.
Les systèmes que nous assemblons ont la garantie indiquée sur votre devis : trois ans retour atelier en standard. Les composants ont la garantie du fabricant, et nous vous aidons à la faire valoir.
Les prix sont affichés hors TVA. La TVA (20%) est ajoutée dans votre panier et sur votre devis. Vous pouvez indiquer votre propre numéro de bon de commande sur un devis.
La livraison au Royaume-Uni coûte £35.00 HTVA, indiqués avant le paiement. Pour les systèmes de grande valeur, nous pouvons fixer un créneau ou demander une signature.
Les clients professionnels peuvent retourner un article en stock non ouvert dans les 30 jours suivant la livraison (demandez-nous d'abord un numéro de retour). Si vous achetez en tant que particulier, vous pouvez annuler dans les 14 jours suivant la réception. Les produits défectueux sont toujours couverts.