Image du produit à titre d'illustration ; la configuration peut différer.
NVIDIA Triton Inference Server (enterprise support and set-up)
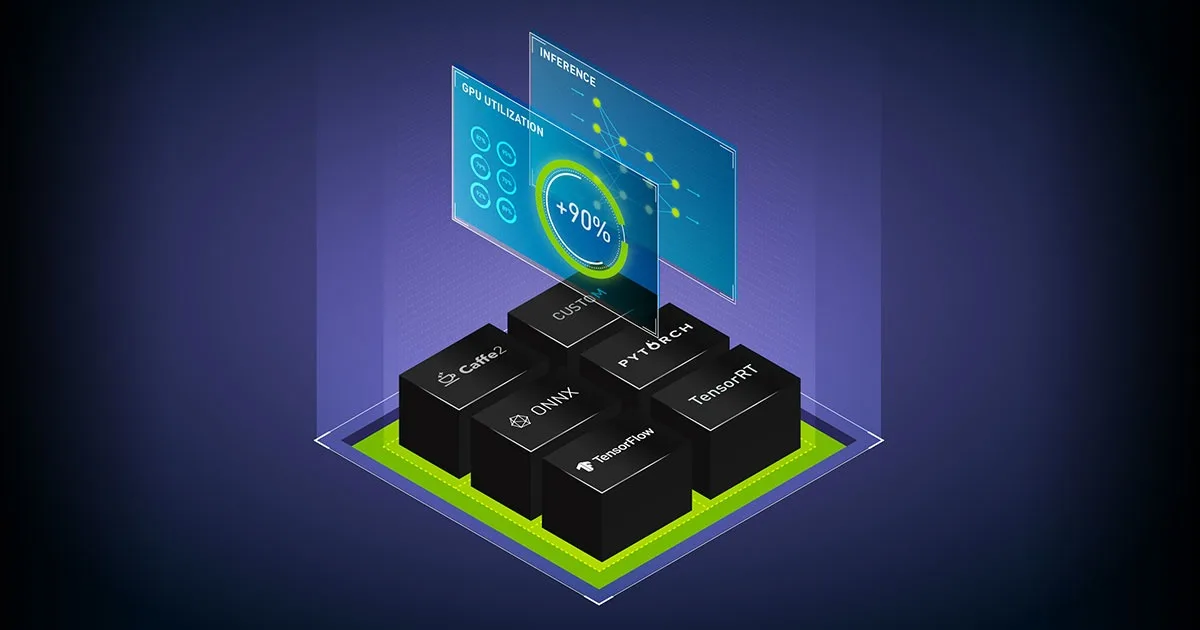
Supported Triton deployment for serving models from many frameworks behind one endpoint.
| Type | Open-source multi-framework model serving |
|---|---|
| Enterprise support | Via NVIDIA AI Enterprise |
NVIDIA Triton Inference Server (enterprise support and set-up) est fabriqué sur commande et chiffré par projet (configuration, livraison, installation et support).
An open-source model server that hosts PyTorch, TensorFlow, ONNX, TensorRT and other models side by side on GPUs or CPUs.
The SDK itself can be downloaded free of charge; what we sell is enterprise support for it through NVIDIA AI Enterprise licences, plus installation and configuration on your hardware by Workstation. Support comes from our own UK engineers, and Trade members get free tech support on every order.
Priced on quote: tell us what you need and we will confirm price, availability and lead time.