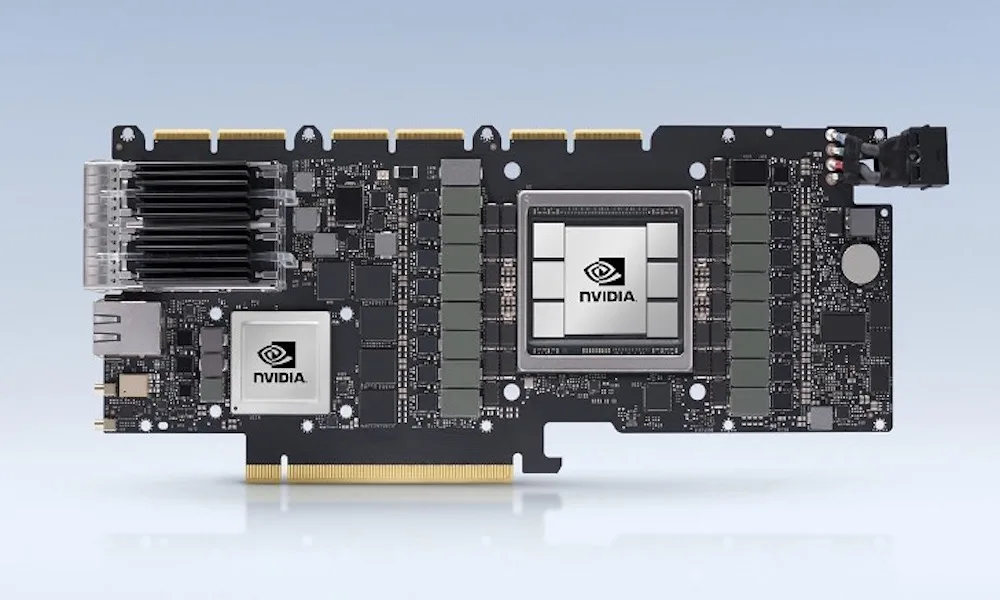
Productafbeelding ter illustratie; de configuratie kan afwijken.
NVIDIA A30X
Ampere A30-class accelerator with 24 GB HBM2e from NVIDIA's converged line.
| Cooling | Passive (server airflow) |
|---|---|
| Form factor | Dual-slot, full height, full length |
| GPU memory | 24 GB HBM2e |
| Architecture | NVIDIA Ampere |
| Interface | PCIe |
NVIDIA A30X wordt op bestelling gebouwd en per project geprijsd (configuratie, levering, installatie en support).
Test een model op onze machines voordat u koopt.
Kies het model en de kwantisatie die u wilt draaien. We tonen of het in het geheugen past, hoeveel ruimte er overblijft voor context en welke doorvoer u mag verwachten. Schattingen zijn gebaseerd op de geheugenbandbreedte en worden vervangen door onze eigen meetwaarden waar we die hebben.
Machine
Kwantisatie
Ruim voldoende. 70 GB over — ruimte voor 128k context, een tweede klein model of een RAG-index in het geheugen. Reken op ongeveer 3.8 tok/s bij één stream.
Machines die deze configuratie draaien
Gewichten 42.8 GB bij 4.85 bits/parameter · KV-cache 5.0 GB bij 16k (fp16, bij benadering) · 10 GB gereserveerd voor OS en runtime. Snelheid is decodering bij één stream, begrensd door het geheugen; promptverwerking en batching gedragen zich anders. Of stuur een engineer een WhatsApp-bericht op +44 7515 356 146.
The A30-class card from NVIDIA's converged accelerator range, for network-intensive inference at the edge or in telco data centres.
Fitted in a Workstation server or supplied standalone. Before it ships we check it against your chassis (power, airflow, risers, slot layout and NVIDIA-Certified status), burn-in test it and install drivers, CUDA, vGPU and NVIDIA AI Enterprise licensing where needed. Warranty claims and advance replacements are handled by us. Support comes from our own UK engineers, and Trade members get free tech support on every order.
Priced on quote: tell us what you need and we will confirm price, availability and lead time.